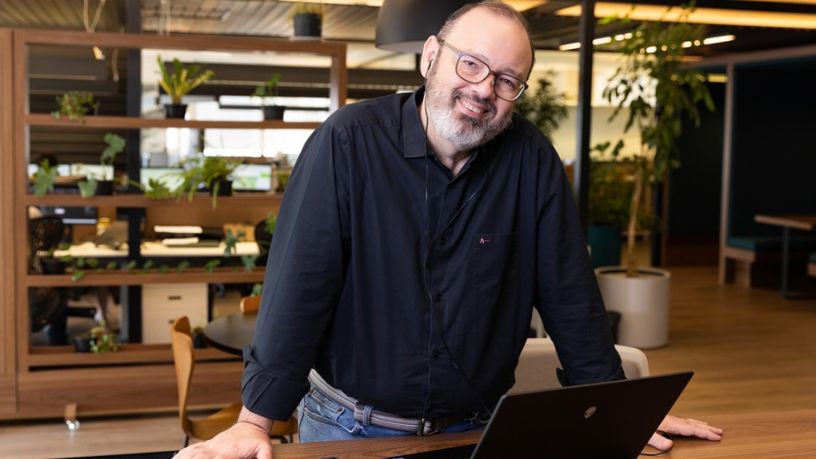
Usar dados de clientes para treinar ou ajustar sistemas de inteligência artificial parece, para muitas empresas, um passo natural. Com base nisso, Murilo Moura Alencar, C-Level e board member, reflete que essa decisão envolve questões jurídicas e de confiança que nem sempre entram no planejamento. No Brasil, o tema ganhou destaque em julho de 2024, quando a Autoridade Nacional de Proteção de Dados determinou a suspensão do uso de dados de usuários brasileiros pela Meta para treinar seus modelos de IA.
A empresa apresentou depois um plano de adequação, e a medida foi revista. O episódio, porém, deixou claro que a Lei Geral de Proteção de Dados se aplica plenamente ao uso de informações pessoais em sistemas de inteligência artificial. A seguir, os pontos que merecem atenção.
Dado de cliente não é matéria-prima livre
A LGPD exige que todo tratamento de dados pessoais tenha uma base legal, como o consentimento do titular, a execução de contrato ou o legítimo interesse da empresa. Também exige que o uso seja compatível com a finalidade informada no momento da coleta.
Esse segundo ponto costuma ser o mais delicado. Dados coletados para prestar um serviço, como processar pedidos ou atender reclamações, não podem ser automaticamente reaproveitados para outra finalidade, como treinar modelos de IA, sem avaliação cuidadosa. A empresa precisa demonstrar que o novo uso é compatível com as expectativas razoáveis do titular.
Transparência é parte da obrigação
No caso analisado pela ANPD, um dos pontos centrais foi a forma como os usuários eram informados sobre o uso de seus dados e como podiam se opor a ele. A autoridade considerou que as informações e os mecanismos de oposição não eram suficientemente claros.
Murilo Alencar aponta que a transparência, nesse contexto, vai além de incluir um parágrafo na política de privacidade. Significa explicar em linguagem simples quais dados serão usados, para quê e como a pessoa pode recusar. Empresas que tratam esse dever como formalidade tendem a enfrentar problemas regulatórios e de reputação ao mesmo tempo.
Dados sensíveis exigem cuidado redobrado
A lei estabelece regras mais rígidas para dados sensíveis, como informações de saúde, origem racial, convicção religiosa, opinião política e dados biométricos. Seu uso em sistemas de IA exige bases legais mais restritas e proteções adicionais.
O risco aumenta porque modelos de IA podem, em algumas situações, reproduzir trechos dos dados com que foram treinados. Informações que pareciam diluídas num grande volume podem reaparecer em respostas inesperadas. Por isso, técnicas como anonimização e minimização dos dados utilizados se tornam ainda mais importantes, assim como testes que verifiquem se o modelo expõe informações pessoais.
Como as empresas podem se preparar
Na visão de Murilo Moura Alencar, o primeiro passo é mapear quais dados pessoais estão sendo usados em projetos de IA, de onde vêm e com qual finalidade foram coletados. Muitas organizações descobrem nessa etapa usos que nunca foram formalmente avaliados.
Em seguida, vale envolver o encarregado de proteção de dados e a área jurídica desde o início dos projetos, documentar a base legal escolhida e elaborar relatórios de impacto quando o tratamento envolver riscos relevantes. Usar dados anonimizados sempre que possível reduz exposição sem necessariamente comprometer o resultado.
Confiança também é ativo
O uso de dados pessoais em inteligência artificial não é proibido, mas exige responsabilidade proporcional ao poder da tecnologia. Murilo Alencar frisa, nesse âmbito, que a legislação brasileira já oferece parâmetros claros, e a atuação da ANPD mostra que eles serão aplicados.
Para empresas de tecnologia, tratar a privacidade como parte do desenho dos projetos, e não como etapa final de conferência, é também uma forma de proteger a relação com os clientes. Em mercados competitivos, a confiança de quem compartilha seus dados pode ser tão valiosa quanto os próprios dados.